Cómo llevar a cabo una investigación éticamente sólida
¿Cuáles son los principios éticos y las consideraciones prácticas en la investigación médica y biomédica. Este curso proporciona las herramientas necesarias par […]
Las más de 230 millones de consultas semanales relacionadas con salud y bienestar obligan a reforzar la supervisión médica del uso de herramientas basadas en inteligencia artificial
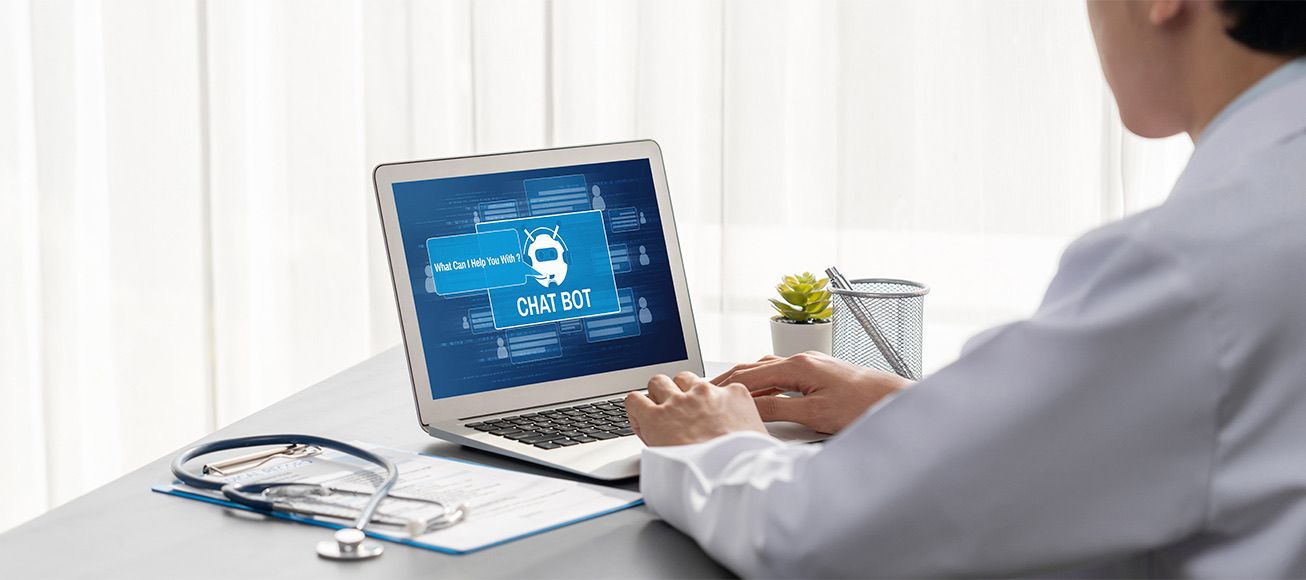
A principios de 2026, la compañía de inteligencia artificial OpenAI puso en marcha ChatGPT Salud para responder a las más de 230 millones de consultas sobre salud y bienestar que recibe por semana, educar a pacientes y ofrecer apoyo informativo a cualquier persona, incluidos los profesionales sanitarios1.
Este servicio creado con más de 260 profesionales médicos de 60 países forma parte de la evolución de los modelos de lenguaje de gran tamaño (LLM, por sus siglas en inglés) hacia el ámbito clínico y busca ofrecer respuestas relacionadas con síntomas, enfermedades, pruebas diagnósticas, tratamientos y organización de información médica1.
Eso sí, la empresa cofundada por Sam Altman insiste en que ChatGPT Health no sustituye al médico, no establece diagnósticos definitivos ni prescribe tratamientos, con lo cual jamás se debe emplear como sustituto de la atención médica urgente o para tomar decisiones clínicas sin supervisión profesional1.
OpenAI comenzó el despliegue de ChatGPT Salud en varios países, en otros su acceso está limitado y en algunos existe una lista de espera para usarlo. Su expansión dependerá del establecimiento de acuerdos regulatorios, la adaptación a normativas nacionales y supranacionales y la validación de requisitos sobre privacidad y uso de datos sanitarios1.
La versión gratuita tiene límites de uso y un acceso reducido a herramientas multimodales. Por su parte, los modos de pago ofrecen acceso a modelos con mayor capacidad de razonamiento, gestión de archivos, análisis de imágenes y memoria contextual. Estas funciones, así como la conexión con aplicaciones de bienestar, permiten cargar resultados analíticos, informes clínicos o pruebas radiológicas para obtener explicaciones más detalladas1.
La compañía señala que puede utilizar las conversaciones para mejorar sus modelos LLM, salvo que el usuario modifique la configuración de privacidad o abone planes con controles adicionales. En cualquier caso, incorpora restricciones sobre almacenamiento de información sensible y mecanismos para reducir respuestas peligrosas y no ofrecer consejos clínicos de alto riesgo2.
En la práctica clínica, ChatGPT Salud se puede aplicar para resumir informes, aclarar lenguaje técnico, elaborar materiales sobre educación sanitaria, organizar antecedentes médicos, generar preguntas para una consulta o ayudar en tareas administrativas1.
Algunos médicos consultan este servicio como apoyo para revisar guías clínicas, redactar documentación o preparar explicaciones para pacientes, mientras que los pacientes pueden usar la herramienta para interpretar síntomas o recibir orientación antes de acudir a una consulta1.
La utilidad diagnóstica de los modelos LLM varía según la enfermedad y el tipo de información. Por ejemplo, un estudio sobre diagnóstico radiológico de patología ósea en extremidades superiores mostró que la versión 4.0 de ChatGPT sólo ofreció diagnósticos en el 52 % de las imágenes que analizó, en las que alcanzó niveles de precisión entre el 0 % y el 55 %. Los resultados fueron inferiores en fracturas de escafoides y metacarpianas, y mostró más dificultades con resonancias magnéticas que con tomografías computarizadas3.
Sin embargo, los resultados cambian en entornos con imágenes más estructuradas y tras un entrenamiento visual homogéneo: un análisis del trabajo de varias inteligencias artificiales sobre patología oral mediante imágenes histológicas mostró que ChatGPT alcanzó un 94 % de precisión diagnóstica y mostró la mayor consistencia entre evaluaciones repetidas, cuando los patólogos humanos lograron una precisión del 98 %. Los errores aparecieron sobre todo en casos ambiguos o con hallazgos superpuestos4.
¿Cuáles son los principios éticos y las consideraciones prácticas en la investigación médica y biomédica. Este curso proporciona las herramientas necesarias par […]
Estos resultados reflejan una diferencia que existe entre reconocer patrones y desarrollar razonamientos clínicos completos. Los modelos de lenguaje funcionan mejor cuando trabajan sobre imágenes estandarizadas o con preguntas estructuradas, pero tienen más problemas en cuadros con síntomas difusos, pacientes pluripatológicos o situaciones que requieren integrar el contexto clínico, los antecedentes sociales y la evolución temporal4.
Otro problema reside en los errores propios de la IA. Algunos modelos generan “alucinaciones”, respuestas incorrectas expresadas con apariencia de seguridad. También pueden reproducir sesgos de autoridad, priorizar patrones frecuentes frente a cuadros raros o responder según guiones estadísticos, aunque la situación clínica no encaje5.
De hecho, un estudio sobre esclerosis múltiple detectó diferencias importantes entre modelos en transparencia, reconocimiento de incertidumbre y calidad de la información: ChatGPT mostró fortalezas en respuestas estructuradas, pero debilidades en contenidos dirigidos a niños y poblaciones vulnerables6.
La gestión de la incertidumbre constituye uno de los principales límites clínicos de los LLM, debido a que algunos modelos tienden a omitir matices o a simplificar recomendaciones complejas. Esto puede inducir a error cuando el paciente interpreta la respuesta como equivalente a una valoración médica. El peligro de recibir conclusiones erróneas aumenta cuando se trata de enfermedades neurológicas, autoinmunes o psiquiátricas, donde el diagnóstico depende de exploración física, evolución clínica y pruebas complementarias6.
El uso inadecuado de ChatGPT Salud también plantea riesgos legales y éticos, ya que compartir datos clínicos sin control afectaría a la privacidad del paciente2. Además, una dependencia excesiva puede retrasar diagnósticos reales, aumentar la ansiedad o favorecer la automedicación. En el ámbito profesional, el uso de contenidos generados por IA sin revisión facilita que se produzcan errores en informes, consentimientos o recomendaciones clínicas6.
En gran parte, la calidad del resultado depende de cómo se utilice la herramienta. Las respuestas mejoran cuando el usuario aporta preguntas concretas, contexto clínico claro y documentación organizada. En cambio, introducir datos incompletos, síntomas aislados o imágenes de baja calidad potencia los errores. Hasta el propio sistema es capaz de ofrecer respuestas distintas a una misma pregunta formulada de otra forma4.
Por todo ello, los médicos se deben adaptar a la nueva situación: no sólo centrarse en transmitir información, sino también validar, contextualizar y corregir las respuestas generadas por IA. Esto implica identificar errores, detectar omisiones y evitar que el paciente tome decisiones clínicas por sí mismo. Al mismo tiempo, deben conocer los límites técnicos de los modelos LLM para no delegar procesos diagnósticos complejos en modelos estadísticos, ya que la responsabilidad clínica y legal continúa recayendo sobre ellos4.
La evolución de estos sistemas apunta hacia modelos multimodales capaces de integrar texto, imagen, voz y datos clínicos, siempre con supervisión humana. Herramientas como ChatGPT Salud pueden actuar como apoyo en educación sanitaria, triaje, documentación o segunda revisión, pero todavía no alcanzan el nivel de juicio clínico requerido para sustituir la toma de decisiones médicas5.
Fuentes:
1. OpenAI, Presentamos ChatGPT Salud https://openai.com/es-ES/index/introducing-chatgpt-health/
2. OpenAI, What is ChatGPT Health? https://help.openai.com/en/articles/20001036-what-is-chatgpt-health
3. Sage Journals, Is Artificial Intelligence the Future of Radiology? Accuracy of ChatGPT in Radiologic Diagnosis of Upper Extremity Bony Pathology https://journals.sagepub.com/doi/10.1177/15589447241298982
4. Scientific Reports, Human versus artificial intelligence in oral pathology diagnosis: a comparative study of ChatGPT, Grok, and MANUS https://www.nature.com/articles/s41598-026-40792-0
5. Revista Española de Patología, Posibles beneficios, desafíos, dificultades y perspectivas futuras del uso de ChatGPT en patología https://www.sciencedirect.com/science/article/abs/pii/S1699885524000424
6. PLOS One, Evaluation of the performance of large language models in responding to medical questions related to multiple sclerosis: A case study of large language models including ChatGPT, Gemini, Grok and Copilot https://journals.plos.org/plosone/article?id=10.1371/journal.pone.0346445
Los profesionales sanitarios enfrentan riesgos biológicos, trastornos mentales y otros factores que afectan su salud. Conoce las enfermedades más frecuentes y cómo prevenirlas.
Conozca cuáles son las diferentes zonas de España en las que más desiertos médicos hay y cuáles son las posibles soluciones propuestas por los médicos jóvenes.
Guía breve con aspectos clave y recursos oficiales para planificar viajes: prevención, vacunas, documentación y medicación, según destino y perfil; útil para sanitarios.
Jubilación médica como nuevo comienzo: riesgos de retirarse por completo, opciones flexibles como docencia, peritaje o ONG, y valor para el profesional y el sistema.
En la última década, los Premios Nobel de Medicina han reconocido avances decisivos en genética, vacunas de ARNm, evolución humana, percepción sensorial, cáncer, ritmos circadianos, autofagia y terapi […]
Conozca los diferentes programas para estudiar fuera de España y cuáles son los trámites que se deben llevar a cabo para conseguir el objetivo de estudiar en el extranjero y hacerlo de la mejor forma […]
Las más de 230 millones de consultas semanales relacionadas con salud y bienestar obligan a reforzar la supervisión médica del uso de herramientas basadas en inteligencia artificial
A principios de 2026, la compañía de inteligencia artificial OpenAI puso en marcha ChatGPT Salud para responder a las más de 230 millones de consultas sobre salud y bienestar que recibe por semana, educar a pacientes y ofrecer apoyo informativo a cualquier persona, incluidos los profesionales sanitarios1.
Este servicio creado con más de 260 profesionales médicos de 60 países forma parte de la evolución de los modelos de lenguaje de gran tamaño (LLM, por sus siglas en inglés) hacia el ámbito clínico y busca ofrecer respuestas relacionadas con síntomas, enfermedades, pruebas diagnósticas, tratamientos y organización de información médica1.
Eso sí, la empresa cofundada por Sam Altman insiste en que ChatGPT Health no sustituye al médico, no establece diagnósticos definitivos ni prescribe tratamientos, con lo cual jamás se debe emplear como sustituto de la atención médica urgente o para tomar decisiones clínicas sin supervisión profesional1.
OpenAI comenzó el despliegue de ChatGPT Salud en varios países, en otros su acceso está limitado y en algunos existe una lista de espera para usarlo. Su expansión dependerá del establecimiento de acuerdos regulatorios, la adaptación a normativas nacionales y supranacionales y la validación de requisitos sobre privacidad y uso de datos sanitarios1.
La versión gratuita tiene límites de uso y un acceso reducido a herramientas multimodales. Por su parte, los modos de pago ofrecen acceso a modelos con mayor capacidad de razonamiento, gestión de archivos, análisis de imágenes y memoria contextual. Estas funciones, así como la conexión con aplicaciones de bienestar, permiten cargar resultados analíticos, informes clínicos o pruebas radiológicas para obtener explicaciones más detalladas1.
La compañía señala que puede utilizar las conversaciones para mejorar sus modelos LLM, salvo que el usuario modifique la configuración de privacidad o abone planes con controles adicionales. En cualquier caso, incorpora restricciones sobre almacenamiento de información sensible y mecanismos para reducir respuestas peligrosas y no ofrecer consejos clínicos de alto riesgo2.
En la práctica clínica, ChatGPT Salud se puede aplicar para resumir informes, aclarar lenguaje técnico, elaborar materiales sobre educación sanitaria, organizar antecedentes médicos, generar preguntas para una consulta o ayudar en tareas administrativas1.
Algunos médicos consultan este servicio como apoyo para revisar guías clínicas, redactar documentación o preparar explicaciones para pacientes, mientras que los pacientes pueden usar la herramienta para interpretar síntomas o recibir orientación antes de acudir a una consulta1.
La utilidad diagnóstica de los modelos LLM varía según la enfermedad y el tipo de información. Por ejemplo, un estudio sobre diagnóstico radiológico de patología ósea en extremidades superiores mostró que la versión 4.0 de ChatGPT sólo ofreció diagnósticos en el 52 % de las imágenes que analizó, en las que alcanzó niveles de precisión entre el 0 % y el 55 %. Los resultados fueron inferiores en fracturas de escafoides y metacarpianas, y mostró más dificultades con resonancias magnéticas que con tomografías computarizadas3.
Sin embargo, los resultados cambian en entornos con imágenes más estructuradas y tras un entrenamiento visual homogéneo: un análisis del trabajo de varias inteligencias artificiales sobre patología oral mediante imágenes histológicas mostró que ChatGPT alcanzó un 94 % de precisión diagnóstica y mostró la mayor consistencia entre evaluaciones repetidas, cuando los patólogos humanos lograron una precisión del 98 %. Los errores aparecieron sobre todo en casos ambiguos o con hallazgos superpuestos4.
Estos resultados reflejan una diferencia que existe entre reconocer patrones y desarrollar razonamientos clínicos completos. Los modelos de lenguaje funcionan mejor cuando trabajan sobre imágenes estandarizadas o con preguntas estructuradas, pero tienen más problemas en cuadros con síntomas difusos, pacientes pluripatológicos o situaciones que requieren integrar el contexto clínico, los antecedentes sociales y la evolución temporal4.
Otro problema reside en los errores propios de la IA. Algunos modelos generan “alucinaciones”, respuestas incorrectas expresadas con apariencia de seguridad. También pueden reproducir sesgos de autoridad, priorizar patrones frecuentes frente a cuadros raros o responder según guiones estadísticos, aunque la situación clínica no encaje5.
De hecho, un estudio sobre esclerosis múltiple detectó diferencias importantes entre modelos en transparencia, reconocimiento de incertidumbre y calidad de la información: ChatGPT mostró fortalezas en respuestas estructuradas, pero debilidades en contenidos dirigidos a niños y poblaciones vulnerables6.
La gestión de la incertidumbre constituye uno de los principales límites clínicos de los LLM, debido a que algunos modelos tienden a omitir matices o a simplificar recomendaciones complejas. Esto puede inducir a error cuando el paciente interpreta la respuesta como equivalente a una valoración médica. El peligro de recibir conclusiones erróneas aumenta cuando se trata de enfermedades neurológicas, autoinmunes o psiquiátricas, donde el diagnóstico depende de exploración física, evolución clínica y pruebas complementarias6.
El uso inadecuado de ChatGPT Salud también plantea riesgos legales y éticos, ya que compartir datos clínicos sin control afectaría a la privacidad del paciente2. Además, una dependencia excesiva puede retrasar diagnósticos reales, aumentar la ansiedad o favorecer la automedicación. En el ámbito profesional, el uso de contenidos generados por IA sin revisión facilita que se produzcan errores en informes, consentimientos o recomendaciones clínicas6.
En gran parte, la calidad del resultado depende de cómo se utilice la herramienta. Las respuestas mejoran cuando el usuario aporta preguntas concretas, contexto clínico claro y documentación organizada. En cambio, introducir datos incompletos, síntomas aislados o imágenes de baja calidad potencia los errores. Hasta el propio sistema es capaz de ofrecer respuestas distintas a una misma pregunta formulada de otra forma4.
Por todo ello, los médicos se deben adaptar a la nueva situación: no sólo centrarse en transmitir información, sino también validar, contextualizar y corregir las respuestas generadas por IA. Esto implica identificar errores, detectar omisiones y evitar que el paciente tome decisiones clínicas por sí mismo. Al mismo tiempo, deben conocer los límites técnicos de los modelos LLM para no delegar procesos diagnósticos complejos en modelos estadísticos, ya que la responsabilidad clínica y legal continúa recayendo sobre ellos4.
La evolución de estos sistemas apunta hacia modelos multimodales capaces de integrar texto, imagen, voz y datos clínicos, siempre con supervisión humana. Herramientas como ChatGPT Salud pueden actuar como apoyo en educación sanitaria, triaje, documentación o segunda revisión, pero todavía no alcanzan el nivel de juicio clínico requerido para sustituir la toma de decisiones médicas5.
Fuentes:
1. OpenAI, Presentamos ChatGPT Salud https://openai.com/es-ES/index/introducing-chatgpt-health/
2. OpenAI, What is ChatGPT Health? https://help.openai.com/en/articles/20001036-what-is-chatgpt-health
3. Sage Journals, Is Artificial Intelligence the Future of Radiology? Accuracy of ChatGPT in Radiologic Diagnosis of Upper Extremity Bony Pathology https://journals.sagepub.com/doi/10.1177/15589447241298982
4. Scientific Reports, Human versus artificial intelligence in oral pathology diagnosis: a comparative study of ChatGPT, Grok, and MANUS https://www.nature.com/articles/s41598-026-40792-0
5. Revista Española de Patología, Posibles beneficios, desafíos, dificultades y perspectivas futuras del uso de ChatGPT en patología https://www.sciencedirect.com/science/article/abs/pii/S1699885524000424
6. PLOS One, Evaluation of the performance of large language models in responding to medical questions related to multiple sclerosis: A case study of large language models including ChatGPT, Gemini, Grok and Copilot https://journals.plos.org/plosone/article?id=10.1371/journal.pone.0346445